Posts mit dem Label LOD werden angezeigt. Alle Posts anzeigen

Montag, 6. Juli 2020

Auf Wikipedia/Wikidata basierende Suchen in swissbib / Recherche dans swissbib basée sur Wikipedia/Wikidata

Deutsche Version Version française

Suche in swissbib basierend auf Informationen aus Wikipedia/Wikidata (oder anderen Quellen)


Sie suchen nach einem kürzlich erschienenen Buch eines Literaturnobelpreisträgers oder einer Bundesrätin oder Bundesrats? Oder nach (öffentlich bekannten) Personen, die in Ihrer Wohngemeinde geboren oder verstorben sind?
Sie möchten sich eine Liste der Medien zusammenstellen, die mit derartigen Fragen in Zusammenhang stehen?
swissbib kann Ihnen Antworten zu diesen und ähnlichen Fragen geben, seitdem die Datenbasis der Plattform im Verlaufe der letzen Monate mit Informationen aus Wikidata, Wikipedia und anderen Quellen verknüpft worden ist. In diesem Blogbeitrag möchten wir Ihnen kurz vorstellen, wie dies funktioniert

Wikipedia stellt einen grossen Fundus an Informationen insbesondere über Personen zur Verfügung. Es ist leicht zu erfahren, dass zum Beispiel Heinrich Böll den Literaturnobelpreis erhalten hat:

https://de.wikipedia.org/wiki/Heinrich_B%C3%B6ll


Das Wikidata-Projekt stellt Wikipedia (und andere Informationen) als Linked Open Data zur Verfügung, so dass diese auch von Maschinen genutzt werden können.

https://www.wikidata.org/wiki/Q42747


Wie bereits angekündigt, haben wir Ende 2019, basierend auf den Arbeiten im Projekt linked.swissbib, die Autoren von swissbib mit Wikidata verknüpft, wobei wir insbesondere die in Bibliotheken üblichen Identifikatoren (GND-, RERO- oder IDREF-Identifikatoren) verwendet haben.

Hier ist ein Beispiel für die über Heinrich Böll gesammelten Informationen

https://data.swissbib.ch/person/ed6314ad-bf79-3db8-bcc4-614ca9359b84


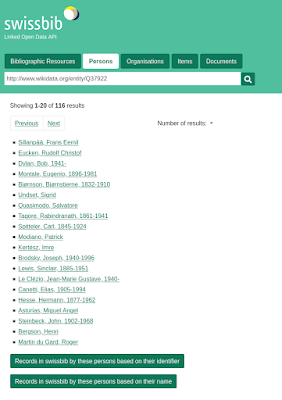
So können wir eine Liste von Personen zusammenstellen, die einen Nobelpreis für Literatur erhalten haben.


https://data.swissbib.ch/person?q=http%3A%2F%2Fwww.wikidata.org%2Fentity%2FQ37922&format=html&size=20


Mit dem Link unterhalb der Zusammenstellung ist es daher möglich, eine Liste der Werke von Personen, die mit einem Literaturnobelpreis ausgezeichnet wurden (Wikidata-Einheit Q37922), in swissbib zusammenzustellen. Sie kann dann mit Hilfe der verschiedenen Facetten nach eigenen Wünschen weiter gefiltert werden:

localhost:9003/person?q=http%3A%2F%2Fwww.wikidata.org%2Fentity%2FQ37922&format=html&size=100&redirectToSwissbib=true


Bitte beachten Sie, dass sich diese Möglichkeit noch im experimentellen (Beta-)Stadium befindet. Hier möchten wir Ihnen jedoch eine Vorstellung des Potentials des Linked-Open-Data-Paradigmas vermitteln.

Es ist jedoch möglich, sehr viel gründlicher als bisher zu recherchieren. Nachfolgend einige Beispiele, die Ihr Interesse anregen mögen:

    Weitere Informationen über für komplexere Abfragen zu verwendende Syntax finden Sie in der Dokumentation auf data.swissbib.ch

    Zögern Sie nicht uns zu kontaktieren wenn Sie Fragen haben !

    Recherche dans swissbib basée sur les informations de Wikipedia/Wikidata (ou d'autres sources)


    Vous êtes vous déjà rendu dans une bibliothèque, à la recherche d'un livre publié récemment et écrit par un prix Nobel de littérature ? Ou par un conseiller fédéral ? Ou par une personne née ou morte dans votre commune de domicile ? Comment en obtenir la liste ?

    Depuis peu, c'est possible dans swissbib ! Comment ça marche ?

    Wikipedia est une source immense d'informations, notamment sur les personnes. On peut par exemple facilement apprendre que Heinrich Böll a obtenu le prix Nobel de littérature :

    https://fr.wikipedia.org/wiki/Heinrich_B%C3%B6ll


    Le projet Wikidata met à disposition les informations de Wikipedia (ainsi que d'autres informations) sous forme de données Linked Open Data, utilisables par des machines.

    https://www.wikidata.org/wiki/Q42747


    Comme annoncé précédemment, fin 2019, en nous basant sur le travail effectué dans le cadre du projet linked.swissbib, nous avons lié les auteurs de swissbib avec wikidata, en nous basant notamment sur les identifiants courants utilisés dans les bibliothèques (identifiants GND, RERO ou IDREF).

    Voici par exemples les informations que nous avons rassemblées au sujet de Heinrich Böll

    https://data.swissbib.ch/person/ed6314ad-bf79-3db8-bcc4-614ca9359b84


    On peut donc obtenir une liste de personnes ayant obtenu un Prix Nobel de Littérature


    https://data.swissbib.ch/person?q=http%3A%2F%2Fwww.wikidata.org%2Fentity%2FQ37922&format=html&size=20


    En utilisant le bouton tout en bas de la liste ci-dessus, il est donc possible d'avoir une liste d'oeuvres de personnes ayant obtenu un Prix Nobel de Littérature (entité Wikidata Q37922) dans swissbib. On peut ensuite la filtrer selon ses désirs en utilisant les différentes facettes :

    localhost:9003/person?q=http%3A%2F%2Fwww.wikidata.org%2Fentity%2FQ37922&format=html&size=100&redirectToSwissbib=true


    Veuillez noter que cette possibilité est encore à l'état expérimental (Beta). Mais ceci peut donner une idée de la puissance du paradigme Linked Open Data.

    Il est donc possible de faire des recherches d'une manière beaucoup plus approfondie que jusqu'à présent. Voici quelques exemples pour vous donner envie :

      Pour de plus amples informations sur la syntaxe à utiliser pour des requêtes complexes, veuillez vous référer à la documentation sur data.swissbib.ch.

      N'hésitez pas à nous contacter si vous avez des questions !

      Montag, 20. April 2020

      Neuauflage der swissbib Linked Open Data API / Nouvelle version de l'API Linked Open Data de swissbib

      Deutsche Version Version française

      Im ersten Teil unserer Blogserie haben wir die wesentlichen Neuerungen der linked swissbib Aktivitäten im letzten Jahr für Benutzerinnen kurz zusammengestellt. Dieser zweite Teil legt seinen Schwerpunkt auf die neuentwickelte Linked Open Data Schnittstelle und möchte den Leserinnen Hintergrundinformationen dazu geben, wie und warum diese als Teil des Projekts linked swissbib entwickelt wurde und welche Gründe zu ihrer Neuimplementierung im letzten Jahr führten.     


      Das swissbib Projekt hat sich bereits sehr früh mit dem Thema strukturierte semantische Daten für das Web (LOD) auseinandergesetzt. Im Jahre 2014 reichten die Projektpartner 


      einen Projektantrag im Rahmen des “Programm SUK 2013-2016 P-2” zur Erweiterung der swissbib-Plattform zu einem Service für verlinkte Metadaten ein.

      Zur weiteren Unterstützung der Umsetzung konnte zusätzlich die Expertise des GESIS – LeibnizInstitute for the Social Sciences gewonnen werden.

      Zu den inhaltlichen 5 Säulen des Projekts zählen:
      • Die Konvertierung aller in swissbib verfügbaren Daten in ein durch das Projekt erstelltes Datenmodell
      • Datenanreicherung durch Verlinkung mit weiteren Quellen
         
      • Erstellung einer REST Datenschnittstelle für die neuen RDF Daten
      • Soweit rechtlich möglich Bereitstellung eines Grossteils der schweizerischen bibliographischen Daten unter der offenen Lizenz CC0
      Das Projekt konnte Ende des Jahres 2016 nach der Errichtung dieser 5 Säulen erfolgreich abgeschlossen werden.

      Dem Programm P2 (jetzt P5) war bei der Genehmigung wichtig, dass die Projektergebnisse in den laufenden produktiven Betrieb von swissbib übernommen und damit Nutzerinnen die Möglichkeiten von semantisch vernetzten Daten aktiv angeboten werden können und das Projekt nicht nur reinen Forschungscharakter hat. Auch dieses Ziel wurde umgesetzt. Alle Daten, die jede Nacht in den Datenhub von swissbib einfliessen (i.d.R. rund 200.000 Dokumente mit Spitzen von mehreren Millionen), werden in den workflow zur Erstellung strukturierter RDF Daten eingespiesen und stehen damit grundsätzlich allen Services der swissbib Plattform sowie den clients unserer Schnittstellen zur freien Verfügung. Innerhalb der Discoverywerkzeuge der swissbib Plattform werden die RDF Daten vor allem für die Seiten mit Personen- und Themeninformationen genutzt, maschinelle clients verwenden die Linked Open Data Schnittstelle.

      Zeit ist verstrichen, Erfahrungen im praktischen Betrieb wurden gesammelt und der Service swissbib entwickelte sich vor allem in den letzten 2 ½ Jahren immer stärker hin zu einer Plattform mit hoher Expertise im Bereich des Management von Daten primär aus dem kulturellen Sektor. Diese Datenkompetenz ist die zentrale Grundlage zur Bereitstellung von Services, die sowohl von Menschen als auch Maschinen genutzt werden können.

      Neuimplementierung der Linked Open Data Schnittstellen

      Welche Gründe führten zur kompletten Neuentwicklung dieser API:
      • Die technische Basis basierte seinerzeit auf dem PHP Framework API platform, das sich damals und auch heute noch grosser Beliebtheit bei der Realisierung von REST Schnittstellen erfreut. Diese Basis passte 2015 auch ideal in den sonstigen Technologiestack des swissbib Projekts. API Platform integrierte als eines der ersten Frameworks überhaupt das Hydra Vokabular als ein Bestandteil der linked data fragments, die eine  leichtgewichtige Variante für Sparql Server ermöglichen. Der Grossteil der Implementierung konnte durch zwei Studenten im Rahmen einer Projektarbeit an der FH Nordwestschweiz umgesetzt werden. Dennoch erwies sich die Techologie als nicht unbedingt passend für die Umsetzung von Anforderungen wie bspw. Reconciliation mit populären tools wie OpenRefine. Hier steht das lobid Projekt des Hochschulbibliothekszentrums Köln Pate für eine erfolgreicher genutzte Datenschnittstelle zur GND. Der von lobid genutzte Technologiestack, das Play Framework, passt unterdessen auch viel besser zur sonstigen swissbib Datenplattform. Der Sourcecode der neuen API ist wie alle anderen Entwicklungen von swissbib frei abruf- und verfügbar.

      • swissbib entwickelt sich immer mehr zu einer Datenplattform, auf der (strukturierte) Daten in Datenpipelines ge-clustert sowie für Services aufbereitet werden und in Zukunft auch für die interaktive Datenanalyse durch Menschen bereitstehen. Dazu setzen wir bereits jetzt Big Data Technologien wie Apache Kafka, Apache Flink und Apache Beam ein. Auf der Elag 2019 gaben wir einen Einblick, wie wir die Datendrehscheibe Apache Kafka für die Orchestrierung von Workflows mit Microservices nutzen. Auf Basis dieser Technologien entwickeln wir Bausteine der swissbib Datenplattform, eine unabdingbare Voraussetzung für zukunftsfähige innovative Services. Mehr Einblick in diese Ideen gaben wir im Rahmen eines Weiterbildungsmoduls.
        In diese Welt lässt sich die technische Basis aus dem Jahre 2015 schlechter integrieren bzw. können wir uns als kleines Team neben dem beschriebenen Kern an Technologien nicht auch noch fokussieren.
         
      • Die seinerzeit entwickelten workflows zur Verlinkung der Daten genügen nicht mehr den heutigen Wünschen und Vorstellungen. Die neuen Datenkomponenten ermöglichen es uns, einen umfassenderen Hub für Personen und Organisationen aus den bibliographischen Ressourcen der swissbib Daten zu erstellen. Diese Identitäten verlinken wir nicht nur mit Ressourcen aus GND, DBPedia und Viaf (bisher) sondern neu mit Wikidata und allen weiteren Datensourcen, die mit den genannten Quellen in Verbindung stehen. Bereits jetzt haben wir einen erheblichen Zuwachs an Verlinkungen. Neu werden wir auf Basis der neuen Technologen weitere Methoden nutzen, um die Verlinkungsqualität stetig zu verbessern.     
      Die neue Datenschnittstelle wird unsere deutlich verbesserten Verlinkungen anderen Diensten einfacher zur Verfügung stellen können. Sie kann die stabile technische Basis für bereits jetzt angedachte funktionale Weiterentwicklungen sein:
      • Reconciliation mit Open Refine  
      • Webabfragesprache GraphQL als Alternative zum REST Modell
      • wir freuen uns über weitere Wünsche und Ideen sowie aktive Mitarbeit 
      Im folgenden dritten Teil unserer Blogserie zu den aktuellen Entwicklungen im Bereich semantische Daten auf der swissbib Plattform werden wir den Schwerpunkt auf praktische Beispiele legen, wie die neuen Funktionen der Schnittstelle https://data.swissbib.ch genutzt werden können. 

      Montag, 30. März 2020

      wikidata Erweiterungen und neue Version data.swissbib.ch / Enrichissements via wikidata et nouvelle version de data.swissbib.ch


      Deutsche Version Version française


      In den letzten Wochen haben wir drei wesentliche Erweiterungen von swissbib online publiziert.

      swissbib ist jetzt mit Wikidata verlinkt


      Seit einigen Wochen ist swissbib mit Wikidata verlinkt. Wikidata ist eine riesige Datenbank, die unter anderem auch die Informationen von Wikipedia enthält. Damit können wir viel umfassendere Informationen zu den Personen im swissbib-Katalog anbieten.

      Seite zur Beschreibung von Albert Einstein in swissbib


      Zahlreiche weitere Verknüpfungen von swissbib mit externen Daten


      Der Workflow, mit dem wir die Informationen zu Personen (z.B. Autoren) und Organisationen innerhalb von swissbib mit Fakten aus verschiedenen externen Datenbanken wie Wikidata verknüpfen, wurde komplett umgestellt. Damit ist zum Beispiel die Zahl der so verlinkten Einzelpersonen von 200'000 auf 2 Millionen angewachsen.


      https://www.swissbib.ch/Record/428632262
      Beispiel für eine bibliographische Ressource mit weitergehenden Informationen zu Personen.

      Neue Version der swissbib Linked Open Data API


      Schliesslich wurde unsere Schnittstelle für Maschinen https://data.swissibib.ch komplett neu implementiert und gestaltet. Sie können jetzt nach Entitäten (Bibliographische Resourcen, Personen, Organisationen...) suchen und erhalten viel umfassendere Informationen.


      https://data.swissbib.ch/person/1295c7bf-c60d-3da4-a034-1f56248c0dd1

      Die in der Linked Open Data API von swissbib verfügbaren Informationen über Albert Einstein

      Weitere Informationen


      Wir werden auf die verschiedenen oben genannten Punkte in künftigen Beiträgen dieses Blogs noch ausführlicher eingehen.

      Montag, 4. Februar 2019

      swissbib version 5

      Deutsche Version Version française

      Seit etwas mehr als zwei Monaten stellt swissbib Schritt für Schritt auf Version 5 um. Viele Komponenten der Software, die swissbib bilden, wurden aktualisiert.

      Benutzeroberfläche (VuFind)

      Für unsere Benutzeroberfläche verwenden wir die Open-Source-Software VuFind. Mit dem jüngsten Update arbeiten wir nun mit VuFind Version 5. Dieses Update bringt für swissbib folgende wichtigsten Verbesserungen mit sich:
      • VuFind 5 ist vollständig kompatibel mit der Bibliotheksverwaltungssoftware Alma von Ex Libris. Durch die Verwendung der APIs von Alma ist es nun auch möglich, direkt in VuFind Ausleihen einzusehen, Dokumentenlieferungen aufzugeben, ein neues Konto zu erstellen usw. Dies könnte nicht nur bei den heute bereits im Einsatz befindlichen Alma-Systemen (bspw. Alexandria-Verbund, Nationalbibliothek) helfen, sondern auch beim kommenden Verbund SLSP.
      • Dank verschiedener Optimierungen ist VuFind 5 schneller als seine Vorgängerversion. Einer der Hauptgründe dafür ist, dass auch das von VuFind verwendete Zend Framework aktualisiert wurde. Die heute eingesetzte Version 3 von Zend hat ebenfalls wichtige Weiterentwicklungen zu seinen Vorgängern erfahren.
      • VuFind 5 ist mit dem neuen Europäischen Datenschutzgesetz (DSGVO) kompatibel.
      • Viele weitere Verbesserungen sind online dokumentiert.

      Suchmaschine (Apache Solr)

      Für unsere Suchmaschine verwenden wir die Open-Source-Software Apache Solr. Wir arbeiten nun mit der Version 7.3 dieser Software (statt der Version 4). Derzeit verfügt swissbib über 30 Millionen Dokumente. Bisher haben wir eine "Master-Slave"-Konfiguration verwendet, d.h. die 30 Millionen Dokumente wurden auf jede Maschine kopiert, die als Suchmaschine diente. Dabei stiessen wir an die Grenzen der Machbarkeit einer solchen Architektur. Beim Upgrade auf Version 7 verwenden wir nun eine SolrCloud-Konfiguration. Das bedeutet, dass die Suche auf mehrere Maschinen verteilt wird. Derzeit setzen wir 4 Maschinen ein, die etwa 7,5 Millionen Dokumente enthalten. Dies ist zwar etwas komplizierter zu konfigurieren, hat aber den grossen Vorteil, dass bei zunehmender Dokumentanzahl einfach Maschinen zur Beibehaltung der Performance hinzugefügt werden können.

      Linked Data

      Auch die Prozesse, die die swissbib-Daten in verknüpfte Daten umwandeln, wurden aktualisiert, insbesondere die Software Metafacture 5, was bereits dazu geführt hat, dass doppelt so viele Autoren in swissbib mit Wikipedia verknüpft sind (vgl. früheren Blog-Artikel zu den Knowledge Cards). Um dies zu sehen, klicken Sie einfach auf das kleine "i" neben dem Namen eines Autors, z.B. https://www.swissbib.ch/Record/162961022.

      Ausblick

      Nach diesen wichtigen Updates unserer Infrastruktur sind wir nun in der Lage, neue Funktionen viel einfacher zu implementieren. Einige unserer Projekte der kommenden Monate:
      • Anzeige der Dokumentenverfügbarkeit direkt in der Ergebnisliste
      • Hinzufügen einer Kantons-Facette mit einer Unterfacette je Bibliothek, die es ermöglicht, die Suche gezielt nach Bibliotheken einzuschränken
      • Deutliche Zunahme der Anzahl an Links zwischen den in swissbib präsentierten Autoren (Knowledge Cards) und ihren Entsprechungen auf Wikipedia
      • Verbesserung der Suchqualität und der Vorschläge, wenn keine Ergebnisse gefunden wurden
      • Bessere Dedublierung der Ergebnisse
      • Möglichkeit der Abstimmung und Anreicherung von Daten mit swissbib über OpenRefine und data.swissbib.ch

      Donnerstag, 22. März 2018

      swissbib mit Personen- und Themeninformationen / Des informations sur les personnes et les sujets dans swissbib

      Deutsche Version Version française

      Auf swissbib.ch stehen drei neue Elemente zur Verfügung, die das Funktions- und Informationsangebot deutlich erweitern.


      • Knowledege Cards für Personen und Themen können während der Recherche über Info-Buttons aufgerufen werden und ermöglichen eine schnelle Orientierung zu einer Person oder einem Thema.
        Zum Beispiel bei dieser Aufnahme: http://www.swissbib.ch/Record/404663893
      • Personen- und Themenseiten enthalten weiterführende Informationen zu einer Person oder einem Thema. Neben den zusätzlichen Angaben sind hier auch Sucheinstiege vorhanden, die eine explorative Suche ermöglichen. So können zum Beispiel Personen mit dem gleichen Genre oder Medien zu untergeordneten Themen entdeckt werden.
        Zum Beispiel:
        Personenseite von Dámaso Alonso
        Themenseite zu Historisches Drama
      • Erweiterte Autocomplete-Funktion, die bei der Eingabe neben Titeln auch VerfasserInnen sowie Themen zur Suche vorschlägt und direkt die Suche in diesen Feldern ermöglicht.
      Diese Elemente wurden im Rahmen des Projekts linked.swissbib.ch erarbeitet und wurden nun in Zusammenarbeit mit der Firma Outermedia in swissbib.ch integriert.
      Basis dafür ist die Transformation der swissbib-Daten in ein RDF-Serialisat sowie die Verlinkung und Anreicherung der Daten. Datenquellen für die angereicherten Daten zu Personen sind DBpedia und VIAF, sofern sie auf akzeptablem Qualitätsniveau sind. Für die Themen werden die Angaben aus der Gemeinsamen Normdatei (GND) bezogen.

      Weitere Hintergrundinformationen für Interessierte finden Sie im swissbib Wiki unter Integration linked. Dazu ist linked.swissbib.ch Quellecode auf Github verfügbar.

      Wir wünschen Ihnen viel Spass beim Entdecken der neuen Möglichkeiten und sind gespannt auf Ihre Rückmeldungen!

      Donnerstag, 7. Dezember 2017

      Was ist neu in swissbib? / Quoi de neuf dans swissbib?

      Deutsche Version Version française

      Liebe Blogleserinnen und Blogleser
      In diesem Jahr war es relativ ruhig auf unserem Blog! Dabei gibt es eine Menge neue Funktionen, die wir schon längst vorstellen wollten. Mit dem hier folgenden Überblick holen wir das nun nach. Wir freuen uns auf eure kundige Einschätzung und euer Feedback.

      Datenquellen


      Die Dokumente der folgenden Quellen sind neu in swissbib zu finden:
      Bis zum Jahresende werden wir ausserdem noch die folgenden Quellen integrieren:
      • Die im Volltext frei zugänglichen Dokumente der Forschungsplattform Alexandria der Universität St. Gallen.
      • Der Bestand der Kantonsbibliothek Thurgau

      Nationallizenzen


      Seit einigen Monaten haben Nutzer mit einem ständigen Wohnsitz in der Schweiz Zugang zu über 6 Millionen Dokumenten aus dem Projekt Nationallizenzen. Der Zugang und die Registrierung erfolgt über swissbib, in Partnerschaft mit dem Projekt SWITCH edu-ID (in swissbib anschauen).

      Über die Nationallizenzen wird zudem die Open-Access-Publikation von Artikeln ermöglicht, die von Autoren, die einer Schweizer Institution angegliedert sind, verfasst wurden. Die betroffenen Metadaten und Volltexte wurden von swissbib aufbereitet und über RERO DOC veröffentlicht. Die Daten stehen auch für die Integration in die Institutionellen Repositories der Schweizer Hochschulen zur Verfügung.

      Weitere Informationen sind in unserem Schlussbericht zum Projekt Nationallizenzen zu finden.

      Linked Open Data


      Das Projekt linked.swissbib.ch wurde Ende April 2017 abgeschlossen. Wir sind gegenwärtig damit beschäftigt, die Projektergebnisse im Hinblick auf eine Integration in swissbib zu konsolidieren.

      Ein wichtiger Schritt war die Identifizierung und Kennzeichnung der offenen Metadaten. Wir freuen uns, dass inzwischen 85 % aller Daten von swissbib als Public Domain zugänglich sind (anschauen).

      Für die Neugierigen unter euch: Werft gerne einen Blick auf data.swissbib.ch und linked.swissbib.ch, um zu sehen, was euch zukünftig erwartet. Die Portale sind aber erst als Beta-Version veröffentlicht. Wir befinden uns noch in der Konsolidierungsphase.

      In einer Artikelserie in unserem Blog haben wir die verschiedenen Prozesse beschrieben. Ausserdem wurde ein Artikel zum Thema Interlinking Large-scale. Library Data with Authority Records publiziert.

      Neue Funktionen


      • Verbesserte Facettensuche: Es ist neu möglich, Suchbegriffe durch Klicken auf das Kreuz rechts des Begriffs auszuschliessen. Mehrere gewählte Themen werden durch UND verknüpft. Die anderen Begriffe (Autoren, Sprache usw.) werden durch ODER verknüpft. Die gewählten sowie die ausgeschlossenen Suchbegriffe sind im Bereich «Filter löschen» sichtbar (weitere Informationen).
      • Verbesserte Anzeige der Hierarchie in den Archivbeständen: Zahlreiche Archivbestände sind in einer hierarchischen Struktur geordnet. In bestimmten Fällen kann diese Struktur im Reiter «Archive/Bestände» in swissbib angezeigt werden. (Beispiel).

      Informationen zum System


      • Unser Datenverarbeitungstool CBS läuft inzwischen auf Version 8.
      • Das Update zur Version 4 unseres Discovery Tools VuFind ist praktisch abgeschlossen.
      • Alle unsere Server laufen nun unter Ubuntu 16.04.
      • Wir haben ein neues Statistik-Tool eingeführt, das auf der Analyse der Logs mit Elastic, LogStash und Kibana basiert.
      • Wir haben Sahi für automatisierte Tests der Web-Interfaces eingeführt.

      Strategie und Zukunft von swissbib


      Ende März 2018 wird die Finanzierung von swissbib durch swissuniversities auslaufen. Gegenwärtig sind wir dabei ein Modell der direkten Finanzierung durch die Bibliotheken einzuführen. Ausserdem planen wir die Integration von swissbb in die Swiss Library Service Platform (SLSP).

      In diesem Rahmen:

      Und zum Schluss noch einige Zahlen


      swissbib zählt heute:
      • Über 30 Millionen Dokumente
      • Über 100 Millionen Exemplare, die in Schweizer Bibliotheken, Archiven oder online zugänglich sind
      • 90’000 Besucherinnen und Besucher pro Monate, die in dieser Zeitspanne 1,3 Millionen Seiten besuchen
      • 5 Personen, die am Projekt arbeiten (das Pensum entspricht 3 Vollzeitstellen)

      Donnerstag, 21. Juli 2016

      Swissbib data goes linked Teil 4: Hydra Web API for smarter clients

      Deutsche Version Version française

      Serie "Swissbib data goes linked"
      Teil 1 | Teil 2 | Teil 3 | Teil 4

      Im vierten und letzten Teil der Artikelserie zum SUK P-2-Projekt linked.swissbib.ch möchten wir uns der Web API für maschinelle Clients widmen. Ziel dieses Teilprojektes ist es, die verlinkten Datenstrukturen über eine REST Schnittstelle in verschiedenen RDF Formaten zur Verfügung zu stellen.

      Illustration 1: REST API als Schnittstelle für swissbib Services
      Die REST API soll dabei eine einheitliche Schnittstelle nach aussen anbieten und gegen innen die Möglichkeit verschiedene Dienste anzubinden. Für Clients der Schnittstelle soll die dahinterliegende Infrastruktur transparent sein.

      REST

      REST (REpresentational State Transfer), ein Programmierparadigma für verteilte Systeme, hat sich in den letzten Jahren gegenüber anderen Ansätzen (z.B. SOAP) aus verschiedenen Gründen durchgesetzt. REST ist leichtgewichtig, skalierbar, einfach verständlich für Menschen und auch relativ einfach zu implementieren für Clients in jeglichen Programmiersprachen. Die Grundsätze eines REST Service sind vereinfacht:
      • Client – Server
        Es gibt eine klare Trennung zwischen Client und Server. Der Client steuert die Interaktionen und der Server verarbeitet Daten oder liefert diese aus.
      • Stateless
        Der Server benutzt nur Daten aus einem einzelnen HTTP Request um die Anfrage zu beantworten und nutzt keine weiteren Kontextinformationen.
      • Cacheable
        Der Inhalt einer Server-Antwort muss implizit oder explizit als cachebar oder nicht cachebar gekennzeichnet sein.
      • Layered System
        Für Server und Client ist transparent ob das Gesamtsystem aus mehreren Abstraktionsschichten besteht oder nicht.
      • Uniform interface
        • Jede Ressource (z.B. eine bibliographische Ressource) ist über eine URL ansprechbar.
        • Eine Ressource kann syntaktisch und semantisch verstanden werden anhand der enthaltenen Daten und Metadaten aus einer Antwort. Das beinhaltet unter anderem die Information in welchem Format (z.B. JSON-LD) die Antwort ist.
        • Wenn ein Client eine Ressource abgefragt hat, hat er damit genug Informationen um die Ressource zu bearbeiten oder zu löschen (vorausgesetzt er hat das Recht dazu).
        • HATEOAS (Hypermedia as the Engine of Application State)
      Diese letzte Anforderung (HATEOAS) ist eine der wichtigsten und doch am meisten vernachlässigte bei vielen REST APIs. Kurz gesagt besagt HATEOAS, dass die API selbstbeschreibend sein muss. Das heisst ein maschineller Client sollte über einen einzigen Einstiegspunkt in der Lage sein zu verstehen welche Aktionen auf welchen Ressourcen über die API ausgeführt werden können. Abstrakt betrachtet stellt ein HATEOAS-konformer REST-Service einen endlichen Automaten dar, dessen Zustandsveränderungen durch die Navigation mittels der bereitgestellten URLs erfolgen.

      Hydra (hypermedia-driven web APIs)

      REST selbst schreibt keinen Standard vor, wie eine selbstbeschreibende API aufgebaut sein soll. Genau an diesem Punkt setzt Hydra an mit dem Versuch das Vokabular für Hypermedia-getriebene Web APIs zu standardisieren. Das Hydra Core Vocabulary ist noch ein inoffizieller Entwurf, der von Google Mitarbeiter Markus Lanthaler vorangetrieben wird und sich besonders im Linked Data Umfeld bereits grosser Beliebtheit erfreut. Das gesamte Vokabular ist schon relativ umfangreich. Um das Prinzip zu veranschaulichen möchten wir hier deshalb nur zwei Beispiele betrachten.

      hydra:entrypoint
      Der Hydra:Entrypoint ist der Startpunkt jeder API. Der Entrypoint selbst, sowie die gesamte API Dokumentation, ist im Format JSON-LD. Im Entrypoint enthalten sind alle weiterführenden Links (zur Zeit noch relative Links) zu den Ressourcen. Im Falle unseres Prototyps sind dies erst die bibliographischen Ressourcen (bibliographicResource). Der Entrypoint unseres Prototyps ist unter folgender URL zu finden: http://sb-vf16.swissbib.unibas.ch/web/

      Illustration 2: hydra:entrypoint des swissbib REST API Prototyps
      (Für Google Chrome Benutzer empfiehlt sich folgendes Plugin: https://chrome.google.com/webstore/detail/jsonview/chklaanhfefbnpoihckbnefhakgolnmc)

      hydra:collection
      Eine Hydra:Collection ist die Sicht auf eine Menge von zusammenhängenden Ressourcen. In unserem Fall könnte das eine Liste der Suchresultate für bibliographische Ressourcen sein. Da eine solche Menge von Ressourcen sehr schnell sehr gross werden kann gibt es im Hydra Vocabulary die Hydra:PartialCollectionView. Diese beschreibt eine Sicht auf eine Untermenge aller Elemente einer Collection. In einer Hydra:PartialCollectionView können Links (hydra:first, hydra:last, hydra:next und hydra:previous) enthalten sein um alle Elemente dieser Sicht abzufragen. Die Ressourcen selbst befinden sich im Feld "hydra:member". Ein Beispiel für eine solche Abfrage findet sich unter folgender URL: http://sb-vf16.swissbib.unibas.ch/web/bibliographic_resources?dct:title=linked%20data

      Illustration 3: Die Ausgabe einer hydra:collection des swissbib REST API Prototyps

      Diese Standardisierung mittels des Hydra Core Vocabulary erlaubt es nun einen generischen Client zu schreiben, der die möglichen Interaktionen mit der Web API auflisten kann. Einen solchen generischen Client zum Entdecken der API hat Markus Lanthaler bereits entwickelt: http://www.markus-lanthaler.com/hydra/console/ (URL: http://sb-vf16.swissbib.unibas.ch/web)

      Prototyp

      Nachdem wir bereits die ersten Resultate des Prototyps gesehen haben, möchten wir noch etwas auf dessen Implementierung eingehen. Eine erste Hydra Referenzimplementierung wurde von Hydra Schöpfer Markus Lanthaler als SymfonyBundle in der Programmiersprache PHP entwickelt. Daraus entstanden vor allem in diesem Umfeld weitere Entwicklungen im Zusammenhang mit Hydra. Unter anderem entstand das Framework APIPlatform. Das Framework wurde zum ersten Mal im Juni 2015 in Version 1 veröffentlicht und steht kurz vor seinem Release in der nächsten Major Version 2.0. Das Framework bietet umfangreiche Hydra Unterstützung. Innerhalb dessen ermöglicht es relativ einfach eigene Datenquellen (DataProvider) anzubinden sowie weitere Serialisierungsformate (über Responder) in der Ausgabe anzubieten. In unserem Prototypen haben wir einen eigenen einfachen DataProvider implementiert, der die verlinkten Daten im Format JSON-LD aus einem Elasticsearch Server lädt. Mit eigens implementierten Responder-Klassen lassen sich dann je nach Anfrage des Clients die Daten in andere RDF Format serialisieren und ausgeben. Die folgende Grafik stellt eine vereinfachte Darstellung des Prozesses dar:


      Der Code des Prototyps ist auf Github einsehbar: https://github.com/linked-swissbib/hydra-swissbib.ch/tree/prototype_v2

      Fazit

      Wir sind überzeugt mit Hydra ein Vokabular für Hypermedia-getriebene Web APIs gefunden zu haben, dass optimal zu unseren verlinkten Daten passt. Mit der Entwicklung des Prototyps konnten wir uns vom Framework API Platform überzeugen und werden In den nächsten Wochen auf Basis des Prototyps die Entwicklung der REST API vorantreiben. Der Aktuelle Stand der Entwicklung kann auf Github verfolgt werden: https://github.com/linked-swissbib/hydra-swissbib.ch

      AutorInnen des Beitrags: