Serie "Swissbib data goes linked"
Das
SUK P-2-Projekt
linked.swissbib.ch baut auf Basis der bestehenden Datensätze von swissbib eine angereicherte und im Sinne des
Semantic Web verlinkte Metadatenstruktur auf (
Abstract,
Präsentation). Den Benutzerinnen und Benutzer des Bibliothekskataloges wird ein Mehrwert geboten, indem durch die Anreicherung von bibliographischen Informationen mit Daten aus weiteren Quellen (DBPedia, VIAF) neue explorative Suchmöglichkeiten zur Verfügung gestellt werden. Durch die Verlinkung mit Referenzdatensätzen des Semantic Web wird zudem die Weiternutzung der Daten auch über die bibliothekarische Domäne hinaus begünstigt.
Dieser und eine Reihe weiterer Artikel sollen einen Überblick über den Stand der Arbeiten im bis Anfang 2017 laufenden Projekt geben. Der Fokus liegt primär auf den verwendeten Applikationen und Techniken sowie auf ausgewählten Details der Implementierung. Die Abfolge der Texte richtet sich ungefähr nach dem konzipierten Workflow für linked.swissbib.ch, welcher folgende Teilschritte vorsieht (s. Abb. 1):
- Transformation der swissbib-Metadaten in ein RDF-Serialisat sowie deren Aufteilung in verschiedene bibliothekarische Konzepte
- Indexierung der transformierten Daten
- Datenanreicherung durch Verlinkung mit weiteren Quellen (im Moment DBPedia und Viaf) mithilfe von LIMES und reshaperdf
- Präsentation der angereicherten Daten in der VuFind-basierten Suchoberfläche
- Web API als maschinell nutzbare Schnittstelle zum Index
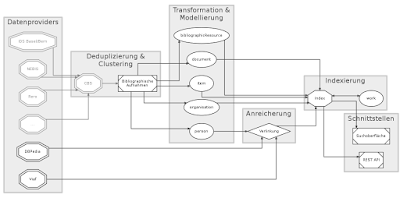 |
| Abb. 1: Übersicht Workflow linked.swissbib.ch (Stand April 2016) |
Teil 1: Metadatentransformation, Modellierung und Indexierung
Metadatentransformation
Grundlage für das linked-swissbib-Projekt bilden die circa 21 Millionen Datensätze im MARC-XML-Format, welche aus einem vorgelagerten Clustering sehr ähnlicher bis identischer Katalogisate resultieren. MARC ist zwar ein weltweit verbreitetes Datenformat, sein Einsatzgebiet ist jedoch auf die Bibliotheken beschränkt. Um eine Weiternutzung auch über diese Domäne zu ermöglichen, ist es daher notwendig, die Daten in einem Format anzubieten, das agnostisch gegenüber einer bestimmten Verwendung ist. Das Resource Description Framework
RDF bietet eine solche Möglichkeit. RDF gibt einen Rahmen vor, in dem über beliebige Dinge (Ressourcen) logische, das heisst maschinell ableitbare Aussagen gemacht werden können. Dadurch, dass in RDF auch Aussagen über Aussagen möglich sind (Reifikation), können domänenspezifische Vokabularien erstellt und diese wiederum miteinander verknüpft werden.
Als Modell gibt RDF ein syntaktisches Schema für Aussagen vor - eine solche entspricht immer einem gerichteten Graphen mit einem Subjekt, einem Prädikat und einem Objekt -, aber kein spezifisches Format. In linked-swissbib haben wir uns für
JSON-LD als Zielformat entschieden, einem
JSON-Dialekt für Linked Data. Das offen standardisierte JSON-LD ist ein relativ versatiles, je nach Verwendungszweck verschieden serialisierbares Format und eignet sich insbesondere auch für maschinenlesbare Schnittstellen.
Um die MARC-Datensätze zu transformieren, benutzen wir
Metafacture, das ursprünglich im Rahmen der
Culturegraph-Plattform entwickelt wurde.
Der grosse Vorteil der Open-Source-Applikation besteht neben ihrer Performanz - Datensätze werden grundsätzlich parallel verarbeitet - in der Möglichkeit, dass MetadatenspezialistInnen ohne Programmierkenntnisse und mit wenig Erfahrung in XML nach kurzer Zeit in der Lage sind, auch komplexe Transformationsregeln zu definieren. Dabei sind zwei Aspekte zentral: Erstens lassen sich mithilfe der domänenspezifischen Sprache Flux sogenannte Metafacture-Commands - die für einzelne Teilschritte in der Transformation stehen, beispielsweise das Einlesen einer Datei oder das Parsen eines bestimmten Formats - zu einer Pipeline zusammenstecken (s. Abb. 2). Die Existenz entsprechender Commands vorausgesetzt, lassen sich so Input- und Outputformat fast beliebig kombinieren. Die eigentlichen Transformationsregeln können dann zweitens in sogenannten Morph-Definitionen (XML-Syntax) auf Ebene der einzelnen Datenfelder deklariert werden. Die Möglichkeiten sind auch hier
sehr vielfältig, erfordern aber bei der Transformation von komplexeren Datenstrukturen ein systematisches Ausprobieren. Damit auch Sonderfälle in den MARC-XML-Daten berücksichtigt werden konnten, wurden in linked-swissbib Qualitätskontrollen mit Stichproben durchgeführt. Die Konversion konnte so inkrementell getestet und verbessert werden.
 |
| Abb. 2: Metafacture-Pipeline (vereinfacht) |
Für das Projekt haben wir Metafacture mit verschiedenen Commands erweitert. Bislang sind das u.a. eine
verbesserte Serialisierung von Dokumenten in JSON-LD, die
Implementierung eines Batch-Mechanismus zur Indexierung auf dem Suchserver und
Methoden zur Interaktion mit einer Graphendatenbank zum Verfolgen von Veränderungen an der Datenstruktur.
Modellierung
Neben der Transformation werden die monolithischen bibliographischen Datensätze in verschiedene Konzepte aufgeteilt. Diese Modellierung hat zum Ziel, sowohl auf die Bedürfnisse der Endnutzer nach verlinkten Daten zu berücksichtigen als auch die Möglichkeiten und Beschränkungen der zur Verfügung stehenden Daten in Betracht zu ziehen. Zu diesem Zweck wurden Use Cases entwickelt und zwei wichtige bibliographische Datenmodelle evaluiert:
FRBR und
BIBFRAME. Ergebnis waren
sechs distinkte Konzepte, die partielle Anreicherung sowie die Verknüpfung der Daten - miteinander und mit externen Quellen erlauben (in Klammern angegeben sind die in der Suchmaschine verwendeten types, die den sechs Konzepten entsprechen, s.u.):
- Aufnahme (bibliographicResource): Bibliographische Daten zur Aufnahme
- Metadaten zur Aufnahme (document): Metadaten zum Datensatz
- Holdings (item): Exemplardaten
- Werk (work): Zusammenzug von bibliographischen Daten verschiedener Manifestationen
- Personen (person): Autoren
- Organisationen (organisation): Körperschaften und Kongresse
 |
| Abb. 3: Prozentualer Anteil der sechs Konzepte |
Aus den 21 Millionen ursprünglichen Datensätze werden so momentan 97 Millionen Dokumente (s. Abb. 3), wobei der grösste Teil auf die Holdings sowie die Aufnahmen und deren Metadaten entfällt. Einige kodierte oder normalisierte Felder erlaubten es, schon in der Modellierungsphase und vor jeder Interlinkingoperation, Links zu externen Referenzdatensets automatisch zu erstellen:
Geonames für Publikationsländer und -kantone, RDA für Medien- und Inhaltstypen und
Lexvo für Sprachen. Zudem wichtig für die Weiternutzung der Daten ist die Verwendung von URI (Uniform Resource Identifiers) für die eindeutige Identifizierung von RDF-Ressourcen (was der ersten der sogenannten
vier Linked-Data-Regeln von Tim Berners-Lee entspricht). Im Projekt konnte für die Generierung solcher URI auf bereits existierende ID in den MARC-XML-Daten oder aber auf auf Feldwerten basierende Hashes zurückgegriffen werden.
 |
| Abb. 4: Relationen der einzelnen Konzepte |
Zwischen den einzelnen Konzepten bestehen verschiedene Referenzierungen (s. Abb. 4), so dass es jederzeit möglich ist, die ursprüngliche bibliographische Ressource wieder zu erzeugen. Jeder Konzept wird mit verschiedenen Eigenschaften in Details beschrieben. Eine statistische Analyse der Datenheiten (Frequenz der Felder und Unterfelder in den MARC-XML-Daten) diente zur Bestimmung der wichtigsten Informationen, die nach RDF überführt werden sollten. Um eine hohe Wiederverwendbarkeit der RDF-Repräsentationen der Daten sicherzustellen, wurden vorwiegend RDF-Properties aus bekannten Fachontologien (
Dublin Core,
BIBO,
FOAF,
RDA, usw.) verwendet.
Indem die Ressourcen fragmentiert indexiert werden, lassen sich aber auch unkompliziert einzelne, eventuell zusätzlich angereicherte Konzepte für
aggregierte Themenseiten, beispielsweise zu einer bestimmten Autorin, aus dem Index auslesen.
Index
Das zentrale Element der linked.swissbib.ch-Infrastruktur ist unser
Suchindex. Sowohl die Suchoberfläche wie auch die Web API werden im produktiven Betrieb direkt auf diesen Index zugreifen, daher sind hohe Verfügbarkeit, performante Indexierung und geringe Latenz bei Suchanfragen entscheidende Faktoren. Im Testbetrieb befindet sich der Index auf einem
Elasticsearch-Cluster mit drei Knoten auf drei verschiedenen Hosts, wobei ein horizontales Skalieren problemlos möglich wäre. Um eine genügend hohe Indexierungsrate zu erzielen, betten wir die Daten in das
Bulk-Format von Elasticsearch ein, welches Batch-Uploads von mehreren Tausend Dokumenten zulässt. So dauert eine Vollindexierung der 97 Millionen Dokumente auf unserem Cluster 6 bis 8 Stunden. Schliesslich arbeitet Elasticsearch intern mit sogenannten shards (Bruchstücke), in die der Index aufgesplittet wird und die ihrerseits über die verschiedenen Knoten im Cluster verteilt werden. Da der Server zudem auf den verschiedenen Knoten Replikate der shards erstellt, kann die Rechenlast bei Abfragen über die Hosts verteilt werden.
Elasticsearch basiert ebenso wie das von "classic" swissbib verwendete Solr auf
Lucene. Im Gegensatz zu Solr serialisiert Elasticsearch Dokumente intern im JSON-Format, womit unsere JSON-LD-Dokumente ohne weitere Anpassungen indexiert und über eine
integrierte REST-Schnittstelle auch wieder ausgegeben werden können. Die Konzepte werden im Suchindex in jeweils einem eigenem
type gespeichert. Ein type ist eine Klasse von Dokumenten (Datensätzen) mit einer Schnittmenge an gleichnamigen Feldern (Schlüssel-Wert-Paaren) und mit einer geteilten Definition (Mapping), wie diese Felder indexiert und analysiert werden müssen. Einzelne Dokumente eines bestimmten types müssen nicht für jedes im Mapping definierte Feld ein Schlüssel-Wert-Paar liefern, anderseits werden aber auch nur diejenigen Paare indexiert, zu denen eine Definition im Mapping existiert. Dies ermöglicht es, auch unterschiedlich vollständige Aufnahmen ohne grossen Aufwand zu indexieren.
Serie "Swissbib data goes linked"
Le projet
CUS P-2 linked.swissbib.ch met en place, sur la base des notices de swissbib, une structure de métadonnées enrichies et reliées selon les principes du
web sémantique (
abstract et
présentation - en allemand). Grâce à l'enrichissement des données bibliographiques avec des informations provenant d'autres sources (DBpedia, VIAF), de nouvelles fonctions de recherche exploratives seront mises à disposition, offrant une plus-value aux utilisateurs du catalogue de bibliothèque. La réutilisation des données, également au-delà du domaine des bibliothèques, sera ainsi favorisée par l'interconnexion avec d'autres jeux de données de référence du web sémantique.
Ce texte et une série d'autres articles donneront un aperçu de l'état des travaux au sein du projet, dont l'échéance est prévue début 2017. L'accent est mis avant tout sur les applications et techniques utilisées ainsi que sur certains détails de l'implémentation. Les différentes contributions de ce blog seront structurées plus ou moins selon le workflow de conception de linked.swissbib.ch, prévoyant les étapes suivantes (figure 1):
- Transformation des métadonnées de swissbib en une sérialisation RDF et décomposition en différents concepts
- Indexation des données transformées
- Enrichissement par l'interconnexion avec d'autres sources (pour l'instant DBpedia et VIAF), au moyen de LIMES et reshaperdf
- Présentation des données enrichies dans l'interface de recherche basée sur VuFind
- API web comme interface vers l'index destinée à d'autres machines
 |
| Figure 1: Aperçu du workflow de linked.swissbib.ch (état avril 2016) |
Partie 1: transformation des métadonnées, modélisation, indexation
Transformation des métadonnées
Les près de 21 millions de notices bibliographiques de swissbib en format MARC-XML, résultat d'une agrégation de notices quasi ou totalement similaires, servent de base au projet linked.swissbib.ch. Bien que MARC soit un format de données utilisé dans le monde entier, son domaine d'application en demeure limité aux bibliothèques. Pour permettre une réutilisation également en-dehors de ce domaine, il est donc nécessaire de proposer les données sous un autre format ne dépendant pas d'une application particulière.
RDF (Resource Description Framework) offre une telle possibilité; il donne un cadre dans lequel des assertions logiques, c'est-à-dire traitables par ordinateur, peuvent être faites sur des choses (des ressources). Par le fait que, en RDF, des assertions peuvent aussi être faites sur d'autres assertions (réification), des vocabulaires spécifiques à un domaine peuvent être créés et, entre eux, interconnectés.
En tant que modèle, RDF définit un schéma syntactique pour des assertions – une assertion correspond toujours à un graphe dirigé contenant un sujet, un prédicat et un objet - , mais pas de format spécifique. Dans linked.swissbib.ch, nous avons sélectionné
JSON-LD comme format de destination. Dialecte de
JSON pour le Linked Data, JSON-LD est un format relativement évolutif, pouvant se structurer différemment selon les utilisations souhaitées, et particulièrement bien adapté aux interfaces de programmation.
Pour transformer les notices MARC, nous utilisons le logiciel
Metafacture, qui a été développé à l'origine dans le cadre de la plate-forme
Culturegraph. Le
principal avantage de cette application Open Source réside, à côté de sa performance – en substance, les notices sont traitées parallèlement –, dans son accessibilité à des spécialistes en métadonnées avec une certaine expérience de XML mais sans connaissances préalables en programmation qui, après une courte étape de familiarisation, sont en mesure de définir des règles de transformation même complexes. Deux éléments sont alors à considérer. Premièrement, le langage dédié FLUX permet de joindre bout à bout des commandes Metafacture (figure 2), qui effectuent les diverses étapes de la transformation, comme la lecture d'un fichier ou l'analyse d'un format particulier. Du moment que ces commandes existent, presque n'importe quelles combinaisons de formats d'entrée et de sortie sont possibles. Deuxièmement, les règles de transformation à proprement parler sont exprimées dans des définitions Morph (en syntaxe XML) au niveau de chaque champ de données. Ici également, les possibilités sont
très variées, mais nécessitent des tests systématiques lors de la transformation de structures de données complexes. Afin que les cas particuliers dans les données MARC-XML soient aussi pris en considération dans linked.swissbib.ch, des contrôles qualité ont été effectués avec des échantillons. Ainsi, la conversion a pu être testée et améliorée de manière incrémentale.
 |
| Figure 2: Pipeline Metafacture (simplifié) |
Pour les besoins du projet, nous avons enrichi Metafacture de plusieurs commandes. Il s'agit jusqu'à présent de commandes pour la
sérialisation améliorée de documents en JSON-LD, pour l'implémentation d'un
mécanisme pour l'indexation par lots sur le serveur de recherche et pour l'
interaction avec une base dedonnées en graphe afin de suivre les modifications de la structure des données.
Modélisation
En plus de la transformation, les notices bibliographiques monolithiques sont décomposées en différents concepts. Le but de cette modélisation est de satisfaire l'utilisateur qui veut des données liées tout en prenant en considération les possibilités et limites des données de base. A cet égard, des
use cases ont été développés et deux modèles de données importants ont été évalués:
FRBR et
BIBFRAME. Cela a résulté en un modèle composé de
six concepts distincts, permettant un enrichissement ciblé ainsi qu'une interconnexion des données – entre elles et avec des sources externes (entre parenthèses sont indiqués ci-dessous les types utilisés dans le moteur de recherche, qui correspondent aux six concepts):
- Instance (bibliographicResource): notice bibliographique
- Métadonnées sur l'instance (document): métadonnées sur une notice bibliographiques
- Exemplaire (item): données d'exemplaires
- Personne (person): auteurs
- Organisation (organisation): collectivités et congrès
 |
| Figure 3: Part en pourcentage des six concepts |
Des 21 millions de notices bibliographiques originales en résultent pour le moment 97 millions de documents (figure 3), dont la plus grande part correspond aux exemplaires ainsi qu'aux instances et leurs métadonnées. Certains champs codés ou normalisés permettent, déjà dans la phase de modélisation et avant toute opération d'alignement, de créer des liens de manière automatisée vers des référentiels externes:
Geonames pour les pays et cantons de publication, RDA pour les types de médias et de contenus, et
Lexvo pour les langues. L'utilisation d'URI (Uniform Resource Identifiers) pour l'identification unique des ressources RDF – correspondant au premier des
quatre principes des Linked Data de Tim Berners-Lee – est également importante en vue de la réutilisation des données. Dans le projet, la génération de ces URI se base sur des identifiants préexistants dans les données MARC-XML ou sur des valeurs de hachage créées d'après le contenu de certains champs. Grâce aux références liant les différents concepts entre eux (figure 4), il est toujours possible de reconstituer une notice bibliographique originale. Chaque concept est décrit en détails par plusieurs propriétés. Une analyse statistique des unités de données (fréquence des champs et sous-champs dans les données MARC-XML) a servi à déterminer les informations les plus importantes qui devaient être transformées en RDF. Des propriétés RDF provenant des vocabulaires les plus connus (
Dublin Core,
BIBO,
FOAF,
RDA, etc.) ont été préférées afin de garantir une bonne réutilisabilité des représentations RDF des données.
 |
| Figure 4: Relations de chaque concept avec le concept "instance" |
Comme les ressources sont indexées de manière fragmentée, les concepts individuels et simples, parfois enrichis, sont facilement accessibles au sein de l'index, par exemple pour générer des pages d'agrégation autour d'un auteur particulier.
Indexation
L'élément central de l'infrastructure de linked.swissbib.ch est son
index de recherche. Aussi bien l'interface de recherche que l'API web accèdent, dans le service en production actuel, directement à cet index. C'est pourquoi une haute disponibilité, une indexation performante et une faible latence sont des facteurs décisifs lors des requêtes. Dans la version test, l'index se trouve dans un cluster d'
Elasticsearch à trois nœuds sur trois hosts différents de telle manière qu'une scalabilité horizontale serait tout à fait possible. Pour atteindre un taux d'indexation suffisamment élevé, nous intégrons les données au
format BULK d'Elasticsearch, qui permet des uploads par lots de plusieurs milliers de documents. Ainsi, une indexation complète des 97 millions de documents dans notre cluster dure de 6 à 8 heures. Enfin, Elasticsearch travaille à l'interne avec des
shards (fragments), dans lesquels l'index est fractionné et qui de leur côté sont répartis sur les différents nœuds du cluster. Comme le serveur crée des reproductions des shards dans les différents nœuds, la charge de calcul lors de requêtes peut être répartie entre les hosts. Elasticsearch se base, tout comme Solr pour swissbib classique, sur
Lucene. Néanmoins, contrairement à Solr, Elasticsearch sérialise les documents à l'interne au format JSON. Nos documents JSON-LD peuvent donc être indexés sans autres adaptations et rediffusés par une
interface REST intégrée. Chaque concept est enregistré dans un
type propre au sein de l'index de recherche. Un type est une classe de documents (de records) partageant une majorité de champs identiques (paires clé-valeur) et contenant une même définition (mapping) précisant comment ces champs doivent être indexés et analysés. Les documents d'un type particulier ne doivent pas contenir une paire clé-valeur pour chaque champ défini dans le mapping par contre, seuls les paires contenant une définition dans le mapping sont indexées. Ceci permet ainsi d'indexer sans trop de difficulté des notices dont l'exhaustivité varie.


